פריצת דרך בבן-גוריון: מחקר חדש חושף מתי ה-AI ימליץ לכם לוותר על טיפול רפואי
26.10.26 / 11:35


בעידן שבו הבינה המלאכותית נכנסת לעולם הרפואה, חוקרים מאוניברסיטת בן-גוריון בנגב ומשירותי בריאות כללית בדקו האם מודלי שפה יודעים לזהות מתי טיפול רפואי או בדיקה הם מיותרים לחלוטין. התוצאות, שפורסמו בכתב עת יוקרתי, חושפות כי המערכות לרוב צודקות, ונוטות לטעות בעיקר בתחומים האפורים שבהם גם הרופאים עצמם חלוקים.
כולנו מכירים את המשפט "בוא נעשה רק בדיקה, ליתר ביטחון", אך בעולם הרפואה, בדיקה נוספת אינה בהכרח דבר חיובי. בדיקות שאינן נחוצות עלולות להוביל לגילוי ממצאים מקריים חסרי משמעות, לחרדה מיותרת, לעומס על מערכת הבריאות, ואף לטיפולים וניתוחים שלא היו נחוצים מלכתחילה. כעת, כשמערכות בינה מלאכותית (AI) הופכות לחלק בלתי נפרד מהעולם הרפואי, עולה השאלה: האם המערכות הללו יודעות לא רק מתי להמליץ על טיפול – אלא גם מתי נכון להימנע ממנו?
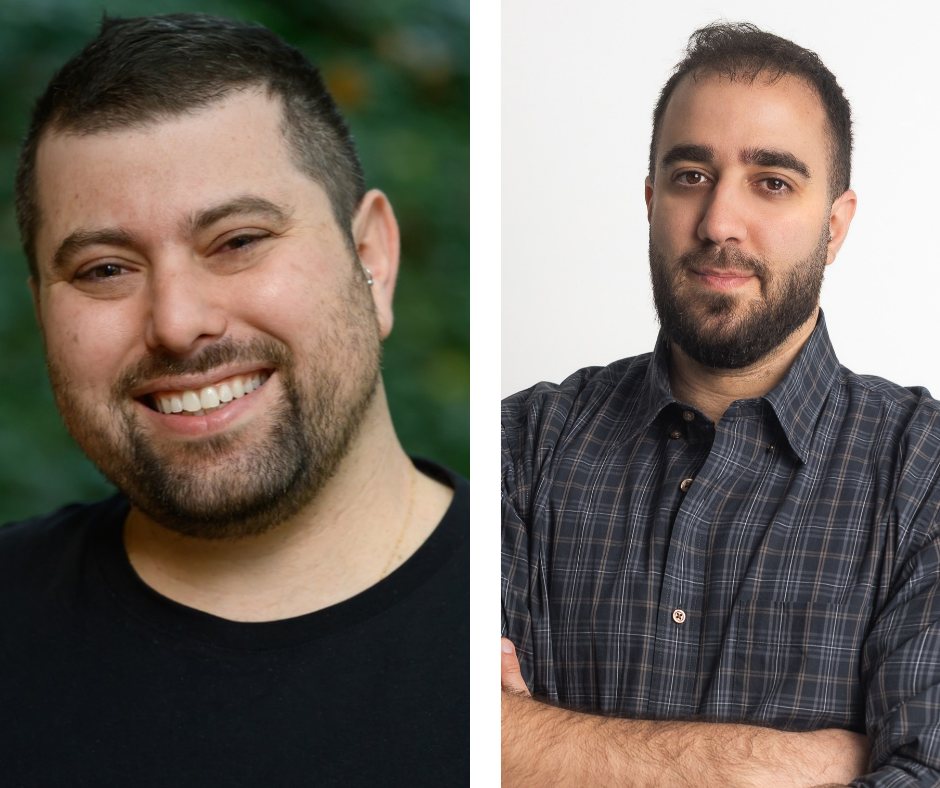
מחקר חדש ומשותף לאוניברסיטת בן-גוריון בנגב ולשירותי בריאות כללית, שפורסם לאחרונה בכתב העת היוקרתי "Annals of Internal Medicine", יצא לבדוק בדיוק את הסוגיה הזו. המחקר הובל על ידי ד"ר דין אריאל, רופא ממחוז תל אביב בכללית, וד"ר גיא לבן מהפקולטה להנדסה באוניברסיטת בן-גוריון בנגב, בשיתוף ד"ר סתיו אנדלמן מהמרכז הרפואי רבין-בילינסון.
במסגרת המחקר, בחנו החוקרים שישה מודלי שפה מובילים של החברות Google, Anthropic ו-OpenAI. המודלים נבחנו על מאות תרחישים רפואיים שהתבססו על יוזמת "Choosing Wisely" האמריקאית, שנועדה לצמצם טיפולים שאינם מוסיפים ערך רפואי. החוקרים הזינו למערכות גם מצבים שבהם נדרשה התערבות וגם מצבים דומים שבהם היא הייתה מיותרת, וניתחו אלפי תשובות.
התוצאות היו מעודדות אך העלו נקודות מעניינות. הנתונים חשפו כי כאשר באמת נדרשה התייחסות רפואית, המודלים המליצו בטעות להימנע ממנה רק ב-0.6% מהמקרים. מנגד, כאשר היה נכון להימנע מבדיקה או טיפול, המערכות המליצו עליהם בכל זאת ב-5.4% מהמקרים.
עיקר הטעויות התרכזו בנושאים שבהם קיימת מחלוקת מקצועית גם בעולם הרפואה המסורתי. כך למשל, המודלים המליצו על ביצוע אולטרסאונד מיותר של בלוטת התריס בכ-42.8% מהתשובות, ועל ביצוע אק"ג שגרתי לאנשים בסיכון נמוך בכ-28.3% מהמקרים. החוקרים מסבירים כי מאחר שגם גופים רפואיים מקצועיים חלוקים לעיתים בנושאים אלו, ה-AI פשוט משקף את חוסר האחידות שקיים בהנחיות הקליניות של בני האדם.
"אחד האתגרים ברפואה הוא לדעת מתי להימנע מפעולה", מסביר ד"ר דין אריאל. "מטופלים מרגישים שעוד בדיקה משרה ביטחון, אבל משם הדרך לחרדה, בדיקות נוספות וטיפולים מיותרים יכולה להיות קצרה. מודלי השפה למדו רפואה מהטקסטים שלנו, כולל מההרגלים הפחות טובים שלנו. ברוב המקרים הם יודעים לעצור, והם מועדים בעיקר היכן שגם אנחנו, הרופאים, מתלבטים".
ד"ר גיא לבן, מהמחלקה להנדסת תעשייה וניהול באוניברסיטת בן-גוריון בנגב, הוסיף פן נוסף לממצאים: "אנחנו שומעים תשובה של מודל שפה כקול סמכותי אחד. לומר 'לא צריך לבדוק' זו פעולה חברתית – רופא צריך לעמוד מאחורי זה מול מטופל מודאג, ומודלי שפה נוטים דווקא להתיישר עם מי שמולם. השאלה הבאה היא אם מודל יידע להחזיק בעמדה הקלינית הנכונה גם כשמתעקשים מולו".
המחקר מציע כעת דרך שיטתית וחשובה למדוד ולהעריך את בטיחותן של מערכות AI בטרם ישולבו באופן מלא בתהליכי קבלת החלטות קליניות במערכת הבריאות.
אנו מכבדים זכויות יוצרים ועושים מאמץ לאתר את בעלי הזכויות בצילומים המגיעים לידינו. אם זיהיתים בפרסומינו צילום שיש לכם זכויות בו, אתם רשאים לפנות אלינו ולבקש לחדול מהשימוש באמצעות כתובת המייל:[email protected]